零点击时代
随着 AI 的普及,大众的搜索行为逐渐从「Google」、「百度」等搜索引擎,过渡到 ChatGPT、豆包等对话式 AI 中。
另外在 2024 年 5 月,Google 在美国举行的 Google I/O 大会上正式推出 AI Overviews,在 Google 搜索结果中,直接通过 AI 摘要为用户提供答案。
这意味着不论是对话式 AI,还是传统的搜索引擎,用户面对大多数问题都可以直接获取答案,而不再(或极少)需要进入到每个网站中自己寻找,通过搜索引擎访问站点的流量极具缩减,这就是「零点击时代」
「零点击时代」的到来,会对传统网站 SEO 造成什么影响?
1)零点击搜索成为常态,"有排名"不再等于"有流量"。 当 AI Overviews 出现时,Ahrefs 对 30 万个关键词的分析显示第一位自然结果的点击率下降 34.5%(2025 年 3 月),到 2025 年 12 月同一研究的更新值已扩大至约 58%;通过AI Overviews获取答案而不进入具体页面成为常态。
2)流量入口碎片化,但 AI 渠道"量小质高"。 ChatGPT 每周处理超过 10 亿次搜索类查询,但带来的引荐流量仅占网站总流量约 0.2%,Ahrefs 的对比是 Google 给网站的流量仍是 ChatGPT 的约 190 倍。另一方面,WebFX 的统计显示 AI 引荐流量在 2024 年 1 月至 2025 年 12 月间增长了约 796%,且多数品类中 AI 引荐访客的转化率高于自然搜索访客。结论:AI 搜索短期不是"流量替代品",而是高意图增量渠道 + 品牌曝光前置位。
3)排名逻辑变化:从"链接权重"转向"被引用"。 AI 模型读的是文本而不是链接图。Ahrefs 对 7.5 万个品牌的研究发现,品牌被第三方提及的频次与 AI 可见度的相关性约为外链数量的 3 倍;多伦多大学 2025 年 9 月的对比研究则显示,各 AI 引擎的引用中 53% 至 95% 来自 earned media(媒体报道、评测、榜单等非品牌自有内容),其中 ChatGPT 高达 90% 至 95%。这意味着只经营官网自有内容已经不够,品牌在全网的"声量实体"变得更关键。
4)关键词研究部分失效,意图理解变得更重。 用户与 AI 的交互是对话式、多轮、口语化的,"北京周边适合带娃的两日游,预算三千以内"这类完整问题正在取代碎片关键词。选题和内容结构需要从"覆盖关键词"转向"解决问题"。
5)品牌曝光形态变化:从"链接"到"答案里的一句话"。 用户在 AI 答案里看到品牌名和一句描述,可能根本不会访问网站。据 Seer Interactive 的研究,被 AI Overviews 引用的网站,其自然点击率比平均水平高出约 35%;品牌词搜索在出现 AI Overviews 时点击率甚至可能上升约 18.68%。曝光正在前移到点击之前,"被引用"本身就成了品牌广告位。
小结:SEO 没有死,但正在从"为排名优化"扩展为"为可见性优化"——同一套内容策略,要同时服务于排名、答案框和 AI 引用三个战场。
生成式引擎优化(GEO)
GEO(Generative Engine Optimization,生成式引擎优化):让你的内容被生成式 AI 引用。典型场景包括 ChatGPT(含搜索模式)、Google Gemini、Microsoft Copilot 等。这些工具把多个来源的信息综合成一段答案,并在答案中标注来源。GEO 竞争的是"引用位"——AI 在生成答案时是否提到你、引用你、如何描述你。
运营策略转变
传统的 SEO 中,拼的是关键词、外链、搜索排名,关注的指标是网站的访问量,而「零点击」导致网站访问量急剧减少,网站的运营则要更关注「转化率」、「AI 引用量」。
重复的内容,AI 只会选最权威的那一个作为引用,相近的内容,小站点在 AI 中没有优势,所以在运营网站时要减少重复内容,提供更多实战性的、多场景化的解决方案。
对于运营人员来说,撰写站点文章时使用 EEAT 框架是有效提升 GEO 的手段:
E-E-A-T 是 Google 搜索质量评估体系的核心框架( Experience(经验)、Expertise(专业)、Authoritativeness(权威)、Trustworthiness(可信))。
在 AI 时代这个框架的意义被放大:AI 引擎本质上更偏好引用"可信、可验证、有明确作者实体"的内容——可以把 GEO 理解为 E-E-A-T 的跨引擎版本。GEO 论文中提升最大的手段(专家引述、统计数据、来源标注)全部指向 E-E-A-T 中的"专业"与"可信"。
- Experience(一手经验):生产实测、数据、案例、前后对比类内容。原创调研、自有数据是 AI 最愿意引用的素材类型;GEO 论文中"加入具体统计数据"可带来约 +30%~40% 的可见度提升。产品与运营团队的一手素材(用户反馈、使用数据、案例复盘)是 SEO 团队拿不到的内容壁垒。
- Expertise(专业署名):内容实名发布,配作者简介、履历和社交链接(Person Schema + 作者页);关键内容(医疗、金融、法律、技术方案)由领域专家审阅并注明。
- Authoritativeness(权威实体):把品牌当作"实体"来经营——Organization Schema、sameAs 链接、权威媒体报道、行业榜单。外链仍重要,但品牌提及与 AI 可见度的相关性已达外链的约 3 倍(Ahrefs);各 AI 引擎 53%~95% 的引用来自 earned media,公关、评测、行业合作从"品牌工作"变成了"AI 可见性基础设施"。
- Trustworthiness(可信呈现):数据注明来源与时间、方法论透明、页面有清晰的联系方式与主体信息、积累真实用户评价。有代理商的数据显示,评论的更新速度(而非总量)是 AI 判断"商家是否在正常运营、服务是否持续"的强信号之一。
根据这个框架,提炼出站点的内容生产机制:
- 选题来自真实问题(GSC 查询、客服工单、销售 FAQ、PAA),而非拍脑袋关键词;
- 每个核心页面包含一个"可直接摘录的答案块"(首段直答 + 结构化数据 + FAQ);
- 同一主题做深做透(主题集群),而不是浅覆盖大量话题——AI 更偏好内容深度;
- 建立更新机制,给内容标注更新日期,过期数据及时刷新。
技术 GEO 策略
技术端的核心目标是三件事:让内容可被抓取、可被理解、可被摘录。
Schema 结构化资料(核心)
Schema结构化资料(Structured Data) 是一种通过标准化代码,向AI大模型明确“这个页面在讲什么、信息有多可信”的语义标注系统。它基于 Schema.org 词汇表(由Google、Microsoft等联合发起),通常以 JSON-LD 格式嵌入网页,充当AI的“机器可读说明书”。
在页面中通过 script 标签嵌入 Json 到页面的 <head> 或 <body> 末尾,只有 AI 爬虫能读取到,不会影响正常浏览页面的人,比如:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "[用户真实会问的问题,而非营销话术]",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "[完整、独立、可单独引用的答案,40–80词]"
      }
    }
  ]
}
</script>
在 Schema 约束中,@context 和 @type 是必要的基础字段,前者定义引用规则,固定写为「https://schema.org」,后者为对应不同的 Schema 类型。
不同的 Schema 类型有着不同的作用:
| 优先级 | Schema类型 | AI用途 | 部署位置 |
|---|---|---|---|
| P0(必装) | FAQPage | 直接答案抽取,引用提升最高 | 含FAQ/知识库/产品Q&A的页面 |
| P0(必装) | Organization | 品牌实体锚定与消歧 | 首页或“关于我们”页 |
| P0(必装) | Article / BlogPosting | 内容归属与作者权威 | 所有博客/资讯/技术文章页 |
| P1(场景刚需) | Product + Offer + AggregateRating | 电商答案中的价格与信誉 | 产品详情页 |
| P1(场景刚需) | HowTo | 分步操作指令的直接引用 | 教程/操作指南页 |
| P2(辅助) | BreadcrumbList / Person / LocalBusiness | 站点结构 / 作者权威 / 本地查询 | 按需 |
FAQPage 问答
问答结构必须在页面渲染的可见内容中,提供与 Schema 完全一致的问答模块,否则存在被判定为“操纵信号”,直接抑制引用
可见指的是必须在页面初始加载时就能被用户直接看到,不能隐藏在「点击」之后,比如 tab、折叠栏等
FAQPage 的约束遵循:
- 答案长度控制在 40-80 词(中文 80-120),过于简单或复杂的答案引用表现都会降低
- 答案必须独立可引用,AI 会直接抽取答案内容,而不会附带页面上线文,所以在答案中不能出现“如上所述”、“见下文”等依赖其他内容的文字
- 答案中避免空泛描述,比如「提升效果明细」,而是用实际数据代替,比如「提升 150% 的浏览量」
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "[用户真实会问的问题,而非营销话术]",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "[完整、独立、可单独引用的答案,40–80词]"
      }
    }
  ]
}
</script>
Organization 主体
声明"这个网站背后是哪个组织"。它是知识面板、品牌实体识别、以及全站其他标记的基础锚点。
这个结构写在「首页」或「关于我们」,全站只定义一次,通过 @id 来定义本实体的全局唯一 ID,@id 通常使用网站域名 + /#organization 进行标记,使用 @id 的好处是首页定义了 organization 信息,其他页面的其他 Schema 结构只要使用相同的 @id,就可以引用这一个 organization 信息
<script type="application/ld+json">
{
  "@context": "https://schema.org",          // 固定写法,声明使用 schema.org 词表,必写且不可改
  "@type": "Organization",                   // 类型。有更贴切的子类型就用:电商 OnlineStore、门店用具体的LocalBusiness 子类、新闻出版 NewsMediaOrganization、股份制公司 Corporation
  "@id": "https://example.com/#organization", // 本实体的全局唯一 ID(URI),必填:有了它,Article.publisher、Person.worksFor 等处只需写                                       {"@id": "https://example.com/#organization"} 即可复用,不重复声明
  "name": "示例科技",                          // 组织官方名。写工商/logo 上的真实名称,不要塞 SEO 关键词
  "url": "https://example.com",              // 官网首页地址,作为该实体的"权威主页"信号
  "logo": {                                  // 品牌标识,影响搜索结果与知识面板里显示哪张图
    "@type": "ImageObject",                  // 写成 ImageObject 对象(而不是纯字符串 URL),才能带尺寸信息
    "url": "https://example.com/logo.png",   // 必须可被抓取:别放在 robots.txt 屏蔽的路径下,也别要求登录才能访问
    "width": 600,                            // 尺寸建议填真实像素。Google 无硬性要求,业内普遍建议最短边 ≥112px,
    "height": 60                             // 推荐矩形横版 logo(正方形小图标效果差)
  },
  "description": "示例科技是一家做企业级数据分析的公司",
                                             // 一句话定位。这段常被 AI 直接摘去当作"这家公司是做什么的",建议写得具体可引用(行业 + 做什么),别写成营销口号
  "sameAs": [                                // 【投入产出比最高的字段】实体消歧核心信号,告诉搜索引擎"下面这些外部档案说的都是同一个主体"
    "https://www.linkedin.com/company/example",
    "https://weibo.com/example",
    "https://zh.wikipedia.org/wiki/示例科技"     // 优先级建议: Wikipedia > Wikidata > 官方社媒 > 行业档案/榜单。只填真实存在、能佐证的;不存在的别编
  ],
  "contactPoint": {                          // 联系方式,支持多个(可用数组写客服/销售/技术支持)
    "@type": "ContactPoint",
    "contactType": "customer support",       // 写明用途。常用值:customer support、technical support、
                                             // sales、billing、press 等,别填自定义组合词
    "telephone": "+86-10-12345678",          // 建议用国际格式 +国家码-区号-号码,能被更多系统正确解析
    "email": "support@example.com"           // 用真实可送达的企业邮箱。注意:标记内容必须是页面上用户可见的,
                                             // 页面上没写的号码不要塞进来
  }
}
</script>
在这个结构中,最重要的字段是:name + url + logo + sameAs,其中 sameAs非常重要,用于消除实体歧义,向 AI 声明“这些分散在不同平台上的账号指向同一个实体”,覆盖的平台越多、链接越稳定,品牌实体信号越强
Article / BlogPosting 文章
把一篇文章的标题、作者、发布/更新时间、配图、发布方拆成机器可读字段。这是内容站最基础的标记,也是 AI 判断"这篇文章值不值得引用、该归给谁"的依据。
headline为标题必填,建议控制在 110 字符内(超长会被截断)image、datePublished、dateModified、author、publisher在 Google 文档中列为"推荐",但缺了会直接导致富媒体结果无法显示,实践中按必填处理。图片建议至少 1200px 宽。dateModifiedAI 在信源评估中会将其作为“内容是否仍在维护”的时效性信号,但要只在内容确有实质更新时才改,不要每次刷新页面就自动更新——虚构的更新时间会被视为误导。- 新闻稿用
NewsArticle,博客用BlogPosting,普通内容用Article。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "@id": "https://example.com/blog/schema-guide/#article",
  "headline": "Schema 结构化数据完全指南",
  "description": "从原理、写法、验证到效果评估,讲清楚结构化数据在 AEO 与 GEO 中的作用。",
  "image": [
    "https://example.com/images/schema-guide-1200x630.jpg",
    "https://example.com/images/schema-guide-800x800.jpg"
  ],
  "datePublished": "2026-10-13T09:00:00+08:00",
  "dateModified": "2026-10-13T09:00:00+08:00",
  "author": {
    "@type": "Person",
    "name": "张三",
    "url": "https://example.com/authors/zhangsan"
  },
  "publisher": { "@id": "https://example.com/#organization" },
  "mainEntityOfPage": {
    "@type": "WebPage",
    "@id": "https://example.com/blog/schema-guide/"
  },
  "articleSection": "技术 SEO",
  "inLanguage": "zh-CN"
}
</script>
Product + Offer 商品
用于标记商品详情页,让价格、库存、品牌、评分变成可被直接读取的字段,是商品页进入商家列表、展示星级的门槛。
- Google 要求 Product 至少具备 offers、review、aggregateRating 之一才有资格展示商品富媒体结果;商家列表(Merchant Listing)要求更严格,价格、库存、币种缺一不可。
- 评分必须是站内真实用户评价的第一方数据,不能引用第三方平台评分,也不能自动生成。
- 价格、库存要与页面实时一致,价格变动后标记必须同步——这是最常见的失效原因。
- 变体商品(多规格)用
ProductGroup+hasVariant,不要把所有价格塞进一个 Product。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "示例智能音箱 Pro",
  "image": ["https://example.com/p/speaker-1.jpg"],
  "description": "支持语音交互的智能音箱,功率 20W。",
  "sku": "SPK-PRO-001",
  "brand": { "@type": "Brand", "name": "示例科技" },
  "offers": {
    "@type": "Offer",
    "url": "https://example.com/p/speaker-pro",
    "price": "899.00",
    "priceCurrency": "CNY",
    "availability": "https://schema.org/InStock",
    "priceValidUntil": "2026-12-31"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.6",
    "reviewCount": "328"
  }
}
</script>
BreadcrumbList 面包屑
用于标记页面中的面包屑,有利于机器理解当前层级,position 必须从 1 连续递增;最后一级(当前页)可以不给 item;面包屑要在页面上可见。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    { "@type": "ListItem", "position": 1, "name": "首页", "item": "https://example.com/" },
    { "@type": "ListItem", "position": 2, "name": "博客", "item": "https://example.com/blog/" },
    { "@type": "ListItem", "position": 3, "name": "Schema 指南" }
  ]
}
</script>
HowTo 步骤
用于教程、步骤的详情页,把操作流程切成有序步骤,Google 已于 2023 年移除 HowTo 富媒体结果(桌面与移动端),不会再现步骤卡片。但标记仍是合法 schema.org 词汇,能帮 AI 识别"这是一个有先后顺序的流程"。
只给真正有离散步骤的内容加;叙事性文章不要硬套 HowTo
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "HowTo",
  "name": "如何给网站添加结构化数据",
  "totalTime": "PT30M",
  "tool": [{ "@type": "HowToTool", "name": "Google Rich Results Test" }],
  "step": [
    {
      "@type": "HowToStep",
      "position": 1,
      "name": "编写 JSON-LD",
      "text": "按页面类型编写对应的 JSON-LD 代码块。",
      "url": "https://example.com/guide/#step1"
    },
    {
      "@type": "HowToStep",
      "position": 2,
      "name": "验证并上线",
      "text": "用 Rich Results Test 验证后部署到线上。",
      "url": "https://example.com/guide/#step2"
    }
  ]
}
</script>
Person 作者
用于标记作者(用户)详情页,并在文章页的Schema中引用作者
AI 引擎和 Google 都在加重"内容是谁写的"这一信号。匿名内容在引用决策里天然弱势。作者标记把"署名"变成一个可解析的实体。
通过 Schama 中的 @id 标注作者主要唯一ID,文章页 Schama 中通过 "author": { "@id": "https://example.com/author/xxx#person" } 引用作者
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Person",
  "@id": "https://example.com/authors/zhangsan/#person",
  "name": "张三",
  "url": "https://example.com/authors/zhangsan",
  "jobTitle": "首席技术专家",
  "description": "十年数据分析经验,负责示例科技的数据平台架构",
  "knowsAbout": ["数据分析", "搜索引擎优化", "结构化数据"],
  "sameAs": [
    "https://www.linkedin.com/in/zhangsan",
    "https://github.com/zhangsan"
  ],
  "worksFor": { "@id": "https://example.com/#organization" }
}
</script>
在文章页中引用作者:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "文章标题",
  "author": {
    "@type": "Person",
    "@id": "https://example.com/authors/zhangsan/#person",
    "name": "zhangsan",
    "url": "https://example.com/authors/zhangsan"
  }
}
</script>
VideoObject 视频
用于标记视频详情页,uploadDate、thumbnailUrl、name 为关键字段;缩略图要可抓取;视频内容要与页面主题一致。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "VideoObject",
  "name": "三分钟看懂结构化数据",
  "description": "用三个例子讲清楚 Schema 是什么。",
  "thumbnailUrl": ["https://example.com/v/thumb.jpg"],
  "uploadDate": "2026-10-13T09:00:00+08:00",
  "duration": "PT3M20S",
  "contentUrl": "https://example.com/v/schema.mp4"
}
</script>
LocalBusiness 商户
用户标记商户详情页,NAP(名称、地址、电话)必须与 Google 商家档案及其他平台完全一致;多门店每店一个页面、一份标记;它不能替代 Google Business Profile。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "LocalBusiness",
  "name": "示例咖啡(国贸店)",
  "image": "https://example.com/shop/guomao.jpg",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "建国门外大街 1 号",
    "addressLocality": "北京市",
    "addressRegion": "北京",
    "postalCode": "100004",
    "addressCountry": "CN"
  },
  "telephone": "+86-10-87654321",
  "geo": { "@type": "GeoCoordinates", "latitude": 39.9087, "longitude": 116.4574 },
  "openingHoursSpecification": [{
    "@type": "OpeningHoursSpecification",
    "dayOfWeek": ["Monday", "Tuesday", "Wednesday", "Thursday", "Friday"],
    "opens": "08:00",
    "closes": "20:00"
  }],
  "url": "https://example.com/shop/guomao"
}
</script>
其他类型
| 类型 | 适用 | 备注 |
|---|---|---|
| Recipe | 食谱 | 富媒体价值高,字段多 |
| Event | 活动页 | 日期/地点必须与页面一致,过期活动要移除或标记状态 |
| JobPosting | 招聘页 | 进入 Google 招聘体验,过期职位必须下架 |
| Course | 课程页 | 2025 年淘汰了旧的单一 Course Info 格式,按新文档实施 |
| SoftwareApplication | 软件/App | 需 applicationCategory、offers |
| Dataset | 数据集 | 仅服务于 Dataset Search,不影响常规搜索结果 |
| QAPage | UGC 问答 | 场景窄,需页面确为单问答结构 |
| Speakable | 新闻 | 仅限新闻类,指向可播报的 CSS 选择器 |
| DiscussionForumPost | 论坛帖 | 2025 年前后新增支持 |
| ProfilePage | 个人/组织主页 | 用于人物档案页 |
Schema校验
在开发阶段,可以通过 https://validator.schema.org/ 对 JSON-LD 的格式、类型定义、必填属性、属性值类型 进行校验
上线后可以通过 https://search.google.com/test/rich-results 测试线上真实 URL 的 Schema 结果
llms.txt
结论:llms.txt 对于提升 AI 引用没有明确的提升,Google 明确忽略,多数 AI 沉默
llms.txt 是 2024 年 9 月提出的站点内容指引文件,思路类似 robots.txt——在域名根目录放一个 Markdown 文件,告诉 LLM"本站最重要的内容和页面是什么"
目前大多数研究表明,**lms.txt 的有无与域名被主流 LLM 引用的频率之间,没有可测量的联系。**Ahrefs(13.7万域名):数据显示,在其样本中,97%的 llms.txt 文件在2026年5月没有收到任何流量。关键结论是:AI 机器人并不会主动去寻找这个文件(对不存在的文件请求量为零)。
所以不值得投入时间研究 llms.txt,更不应该期待通过它带来可衡量的GEO收益,仅作为对未来可能性的一种投资(以后也许会有作用)
SEO(网站性能)
SEO 是 GEO 的基础,AI 也是通过爬虫对页面进行分析,能否快速响应、是否有可见内容,仍是影响爬虫的最重要因素
量化成果
我们必须知道有几个原因,导致 GEO 的效果难以评估:
- AI 输出不稳定:同一问题连续两次提问,只有约 30% 的品牌能保持可见;连续五次仅约 20%。单点数据噪声极大。
- 引用集合每月变动 40%~60%:即使什么都不做,被引页面也会自然轮换。
- 没有干净的因果证据:目前公开的学术研究中,并没有"单独添加 Schema"的因果实验。业界常引用的数据(被引页面中约 61% 使用了 3 种及以上 Schema 类型、约 68.7% 遵循清晰的 H1→H2→H3 层级,见文末参考资料第 9 条)都是相关性统计,不是因果关系。最接近的证据是 2026 年 2 月的 SAGEO Arena 研究:结构性优化(标题、meta、Schema)带来约 +22% 的检索命中率提升,而只改正文反而使检索命中率下降约 9%——结论是"结构驱动检索,正文驱动引用",两者互补。
即使页面没有主动编写Schema相关代码,AI 也能通过页面分析自己得出类似数据,只是不一定准确,所以完善Schema正确的姿势不是追求"精确归因",而是设计一个噪声可控、趋势可信的评估。
可以通过关注网站AI爬虫相关数据,看看是否有增长:
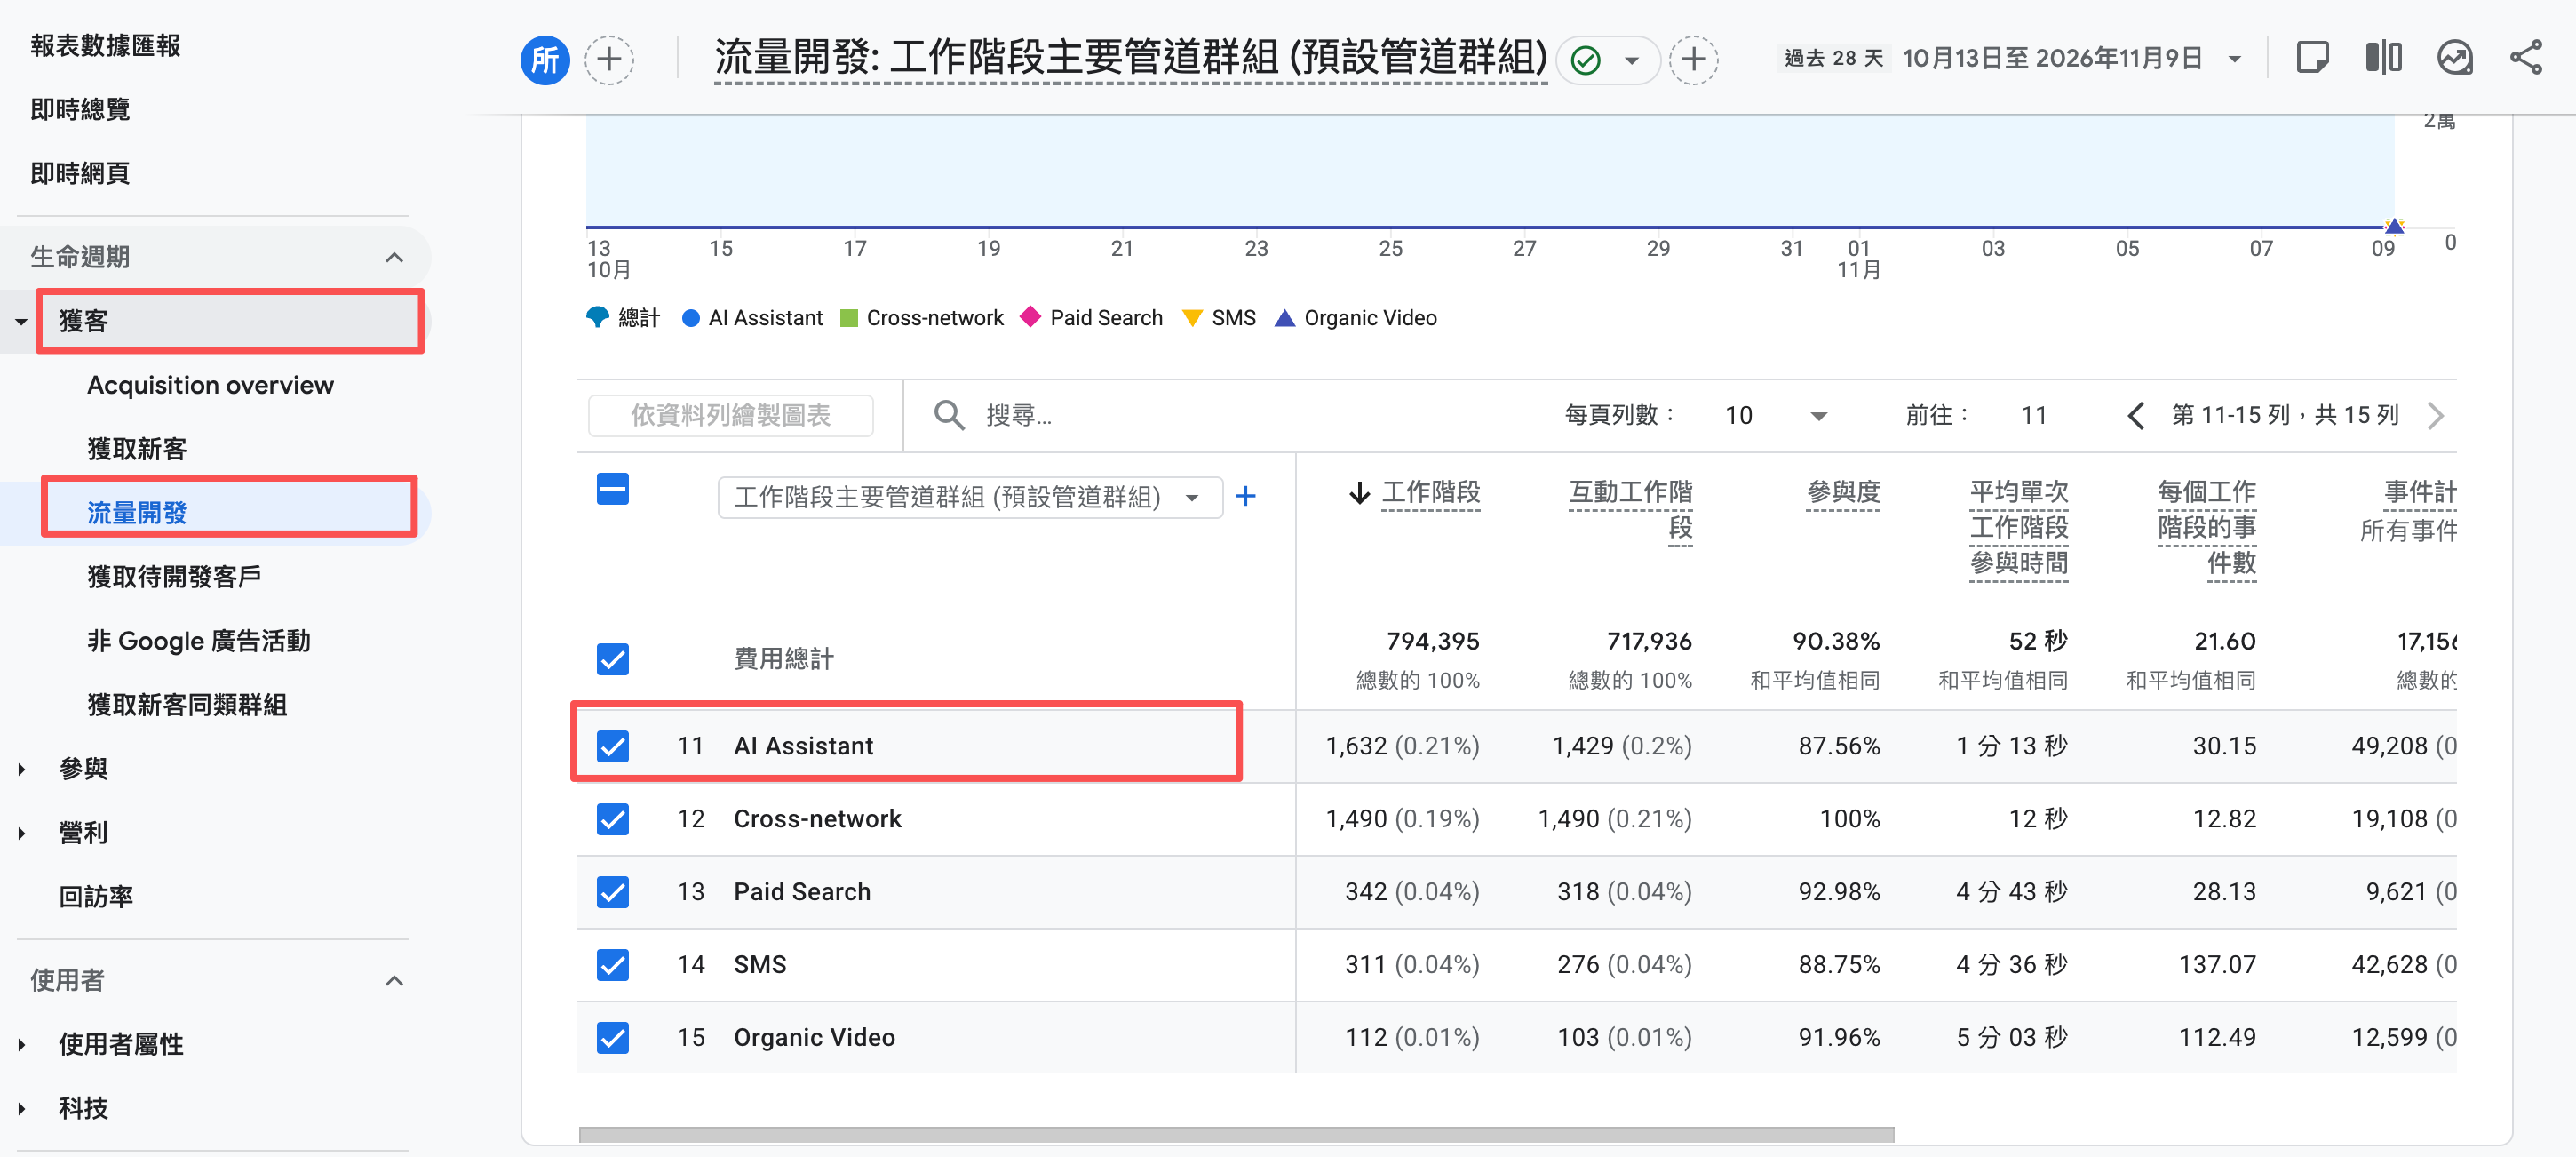
- analytics 平台AI的流量
这个数据代表了 AI 的回答中包含了站点的链接,并且用户访问了该链接。
这个数据很重要,但我们需要注意以下几个局限:
- 作为「AI 引荐」的下限,而非总量更贴切。因为大量 AI 引荐无法被识别,不会进入这个渠道(研究表明,有超过 70% 的 AI 引荐会话到达时完全没有引荐头)
- 流量会被拆分到多个渠道,比如:`chatgpt.com / ai-assistant` 会统计到 AI Assistant 渠道,而 `chatgpt.com / referral`会进入 Referral 渠道,`chatgpt.com / (not set)`会进入 Unassigned 渠道,所以只考虑单一渠道可能低估了 AI 的引荐量
- Google 自家的AI 搜索被排除在外(AI Overviews和 AI Mode),这个渠道只针对第三方 AI 助手
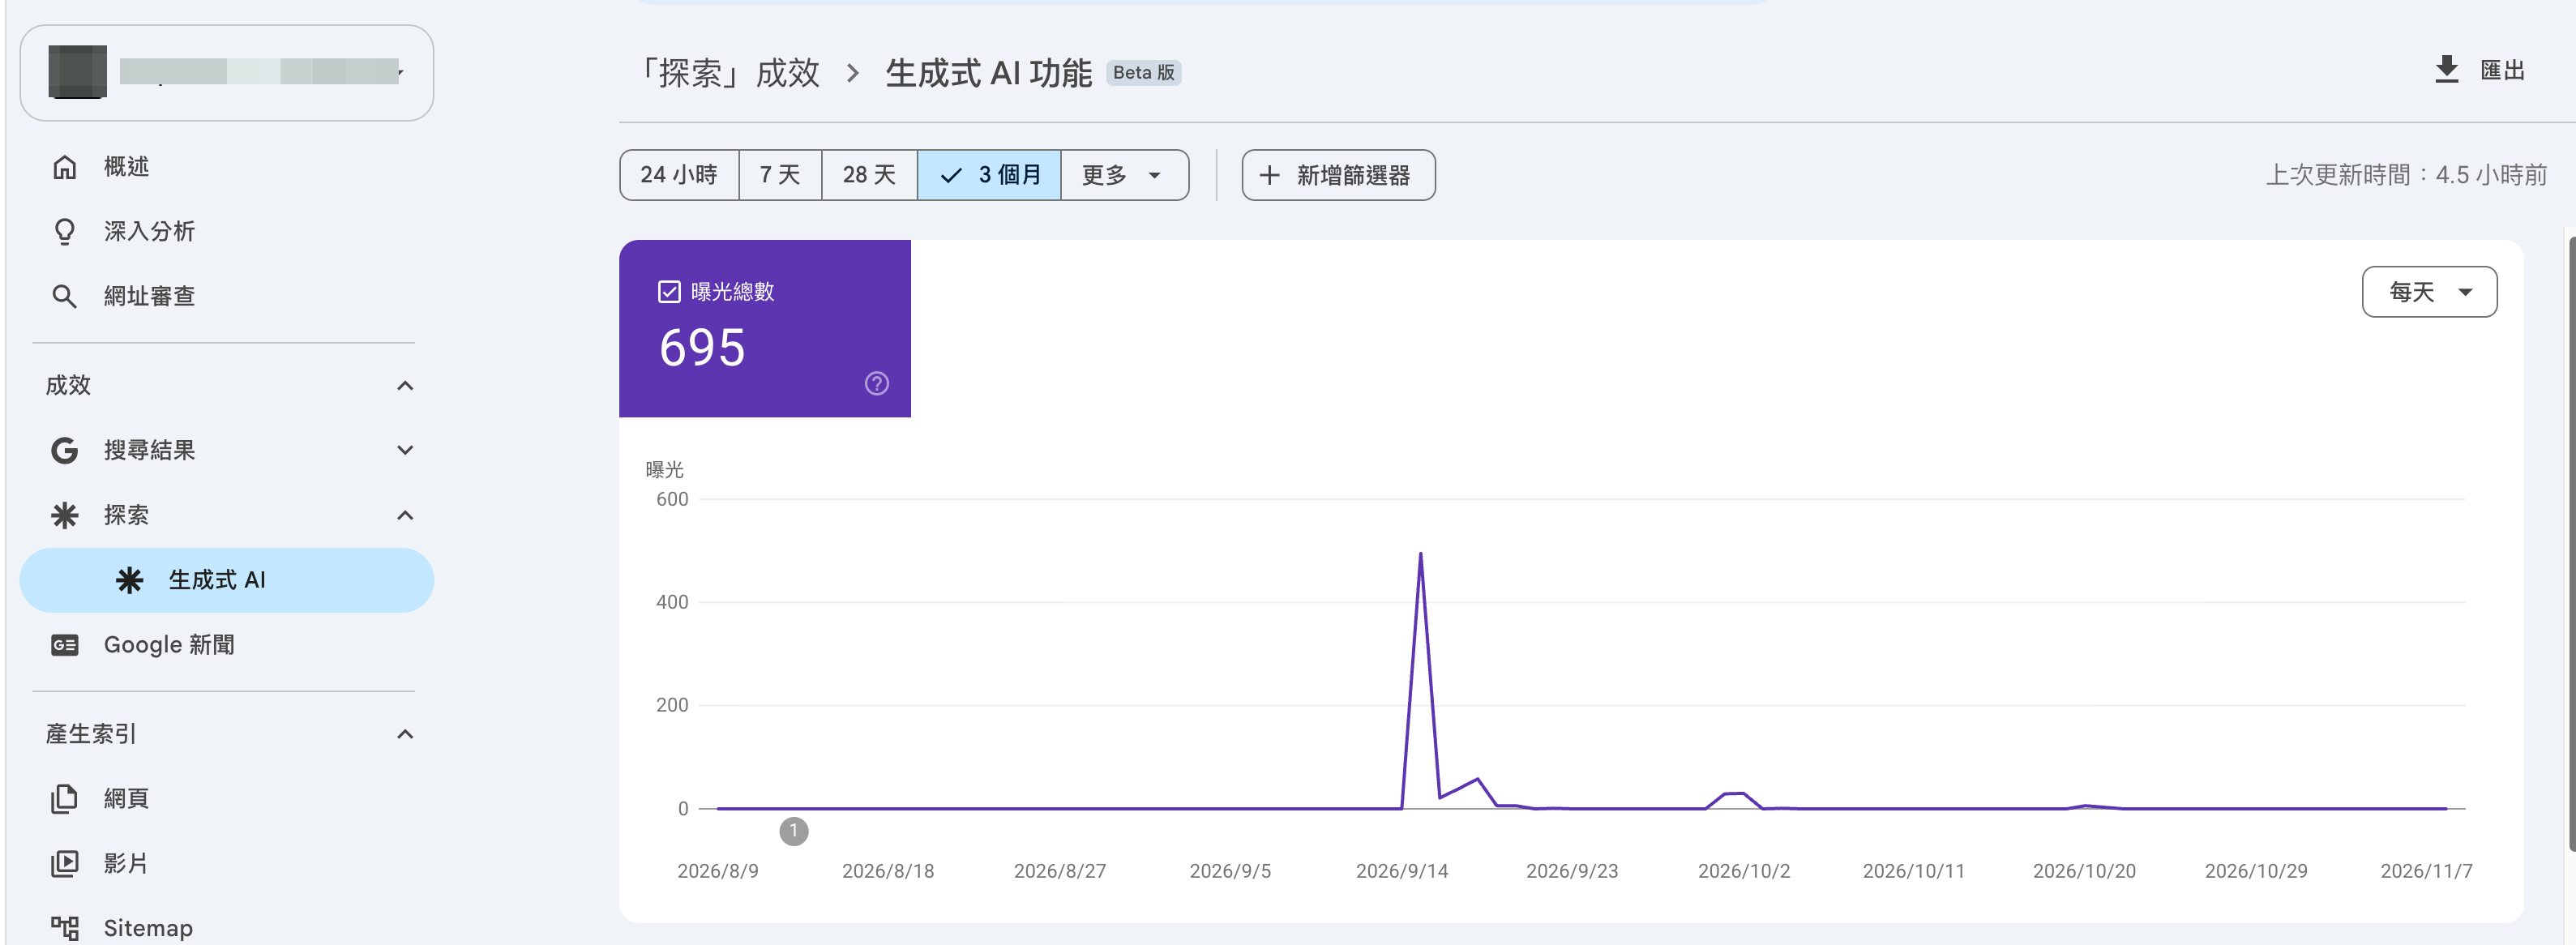
- GSC - 搜寻结果 - 生成式AI
这个数据代表了用户在主动通过Google搜索时,被Google搜索的AI功能引用的次数,主要包含 AI 概率(AI Overviews)和 AI 模式(AI 独立对话框)
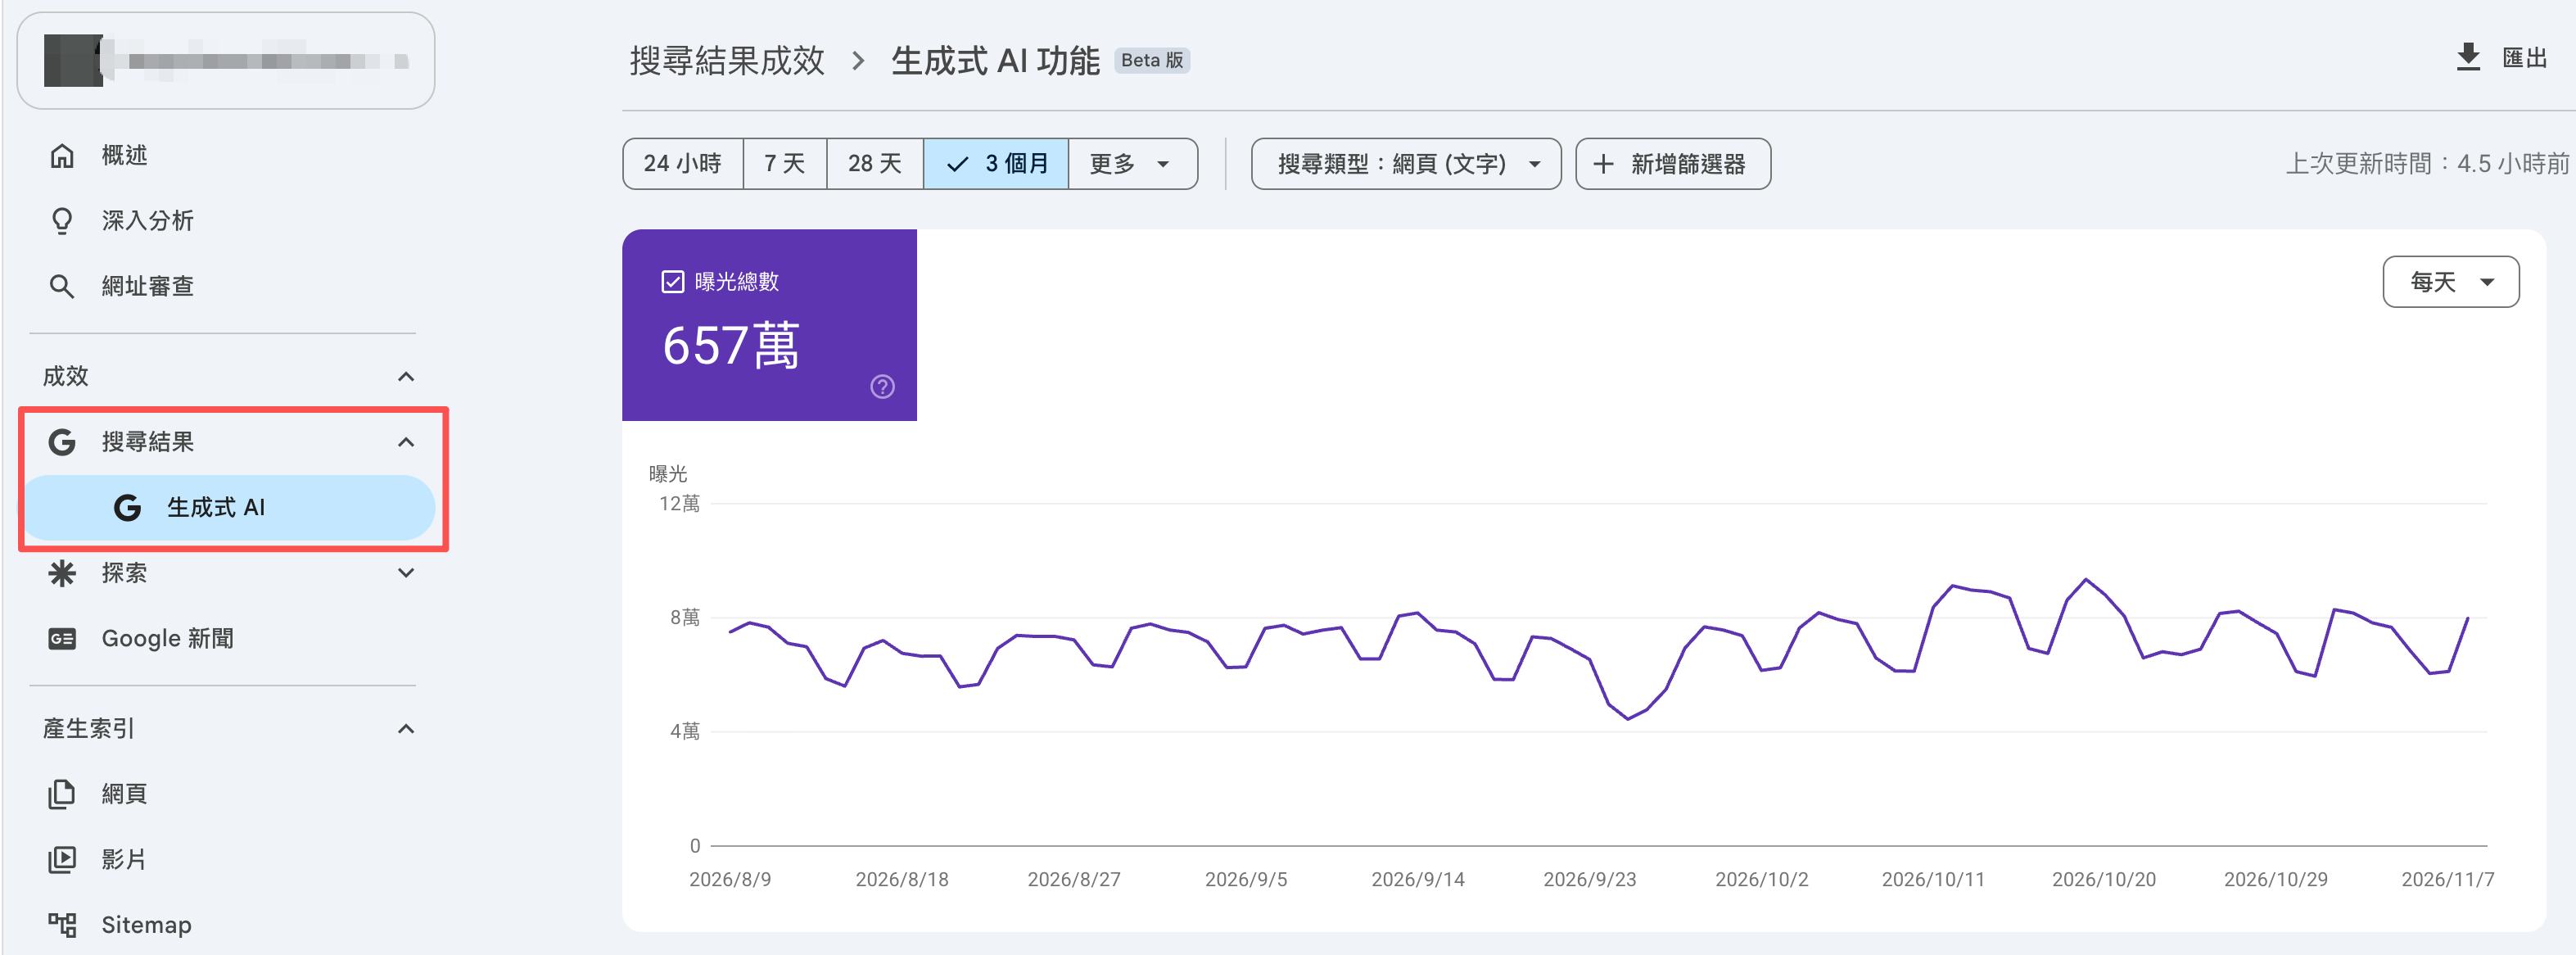
- GSC - 探索 - 生成式 AI
这个数据表示网站内容在 Google App 货首页上浏览的个性化内容推荐流数据,和用户搜索无关,仅反映网站内容在「信息流推荐+AI 生成」场景下的可见度