LLM(大语言模型)
LargeLanguage Modal(大语言模型),是 AI 的大脑,本质上是一个经过海量文本数据训练的深度学习模型,能够理解和生成人类的语言,是人 和 AI 交互的基石。
LLM的原理是「预测」,它就像读过并记住了数亿文字的一台机器,分析出每个词后面出现的概率,形成一套复杂的语言规律,当我们向LLM提问时,它就回利用这一套语言规律,逐字推断出最合逻辑和语境的回答。
LLM很强大,但其本质是基于统计的模式匹配系统,有其局限性:
| 能力 | 说明 | 局限性 |
|---|---|---|
| 知识截止 | 训练数据有截止日期 | 不联网无法获取训练后的新信息 |
| 数学计算 | 简单计算 | 复杂计算容易出错 |
| 实时信息 | 需要外部工具辅助 | 本身无法获取实时数据 |
| 事实准确性 | 基于推测,可能生成错误信息 | 需要事实核查 |
| 长文本处理 | 上下文长度有限制 | 超出上下文长度限制会丢失信息 |
| 逻辑一致性 | 可能前后矛盾 | 需要验证 |
Transformer
Transformer是构建LLM的架构,它改变了之前模型的串行处理数据的低效模型,通过自注意力机制并行处理句子中的每一个词,分析词与词之间的关联度,并分词语分配注意力权重,最终基于对所有词的理解和权重分配,生成完整回答。
Transformer之所以能引发AI发展浪潮,主要是因为:
- 自注意力改变了串行处理数据的模式,通过并行处理能够充分发挥GPU的并行算力,使模型的训练数据从一亿参数拓展到一万亿以上
- Transformer提供了「自注意力层」这一通用计算单元,无论是文字、图片还是语言,都可以转化为序列,在统一套框架里处理,结束了不同类型数据需要专门设计模型的时代
- Transformer之前的小规模模型只能作模式匹配,无法进行复杂推理,而当模型参数规模超过数百亿,模型出现了接近人类的推理、泛化能力
RAG(检索增强生成)
RAG(Retrieval-augmented generation,检索内容生成)简单来说就是:让 LLM 在回答问题时,先从外部知识库检索相关内容,再基于检索结果生成回答。
RAG 主要解决了LLM 的两个痛点:知识截止日期(模型不知道训练后的内容)、幻觉生成(模型在不确定时会编造答案);
通过 RAG 也解决了 LLM 模型无法获取私密数据(公司内容资料、个人笔记)的问题,这项技术常用于开发智能客服、文档助手等功能。
AIGC(人工智能生成内容)
AIGC(AI-Generated Content,人工智能生成内容),所有 AI 生成的内容,包括文字、图片、视频等都属于 AIGC,在 AIGC 前也有其他类型的 GC名词:
- PGC:专业生产内容,只有专业团队/公司才能生产的内容,比如电影、新闻、音乐专辑等
- UGC:用户生成内容,每个人都能产生的内容,比如拍短视频、写文章、做博客等等
- AIGC:AI 生产内容,用户调用 AI 完成文章、图片、视频生成
MCP(模型上下文协议)
MCP(Model Context Protocol 模型上下文协议)是2024 年推出的一种开放协议,用于实现 LLM(大语言模型)应用和外部数据源、工具和服务之间的无缝集成,提升 LLM 应用的功能性、灵活性和可拓展性。
MCP出现之前,AI 要调用外部信息(比如查询数据库、操作文件、发送邮件),开发者需要为每一个接口单独编写定制的代码,这导致开发成本高、工具难以复用。有了 MCP,所有外部工具和 AI 交流都统一标准,大幅降低开发成本。
常见的使用场景如:
- AI 客服,通过 MCP 协议为 LLM 提供内部数据、教程等,对 AI 问答系统进行功能增强
- AI 查票:AI模型没有联网时,无法获取实时信息,特别是一些复杂的票务系统,难以获取以及保证其准确性,通过 MCP 为模型提供查询接口可以实现准确的查票功能
Token(词元)
在 AI 中,Token 是 AI 能理解的最小文本单位,也就是分词,比如:发送一句「你好」给 AI,AI 为了理解你发的内容,可能会把「你」「好」拆分为两个字(Token),也可能将「你好」视为一个 Token,还可能将「你好」两个字拓展为更好理解的多个字,这取决于 AI 底层的分词逻辑。
按经验估算,1000 个 Token 约等于 750 个英文单词/或 500-750个中文字符,因为英文字符只由 26 个字母组成,而中文字符在编码上更复杂,所以也更耗费 Token;而AI 编程的 token 消耗会比自然语言更少,因为编程语言结构紧凑更有规律。
Token更具现实意义的一点是:用于计费,一般普通聊天对话 AI 产品都是免费使用,比如豆包、千问、元宝、DeepSeek 等,而收费的内容通常是 API 调用,比如你想将 DeepSeek 接入自己的应用、网站,或者你需要 AI 拓展 AI 的能力,比如接入自己的私密知识库、实现自家产品的 AI 智能客服等,就需要使用 API 调用;
Token 计费通常分为输入和输出,并且输出内容通常比输入更贵,比如 DeepSeek 收费规则如下:
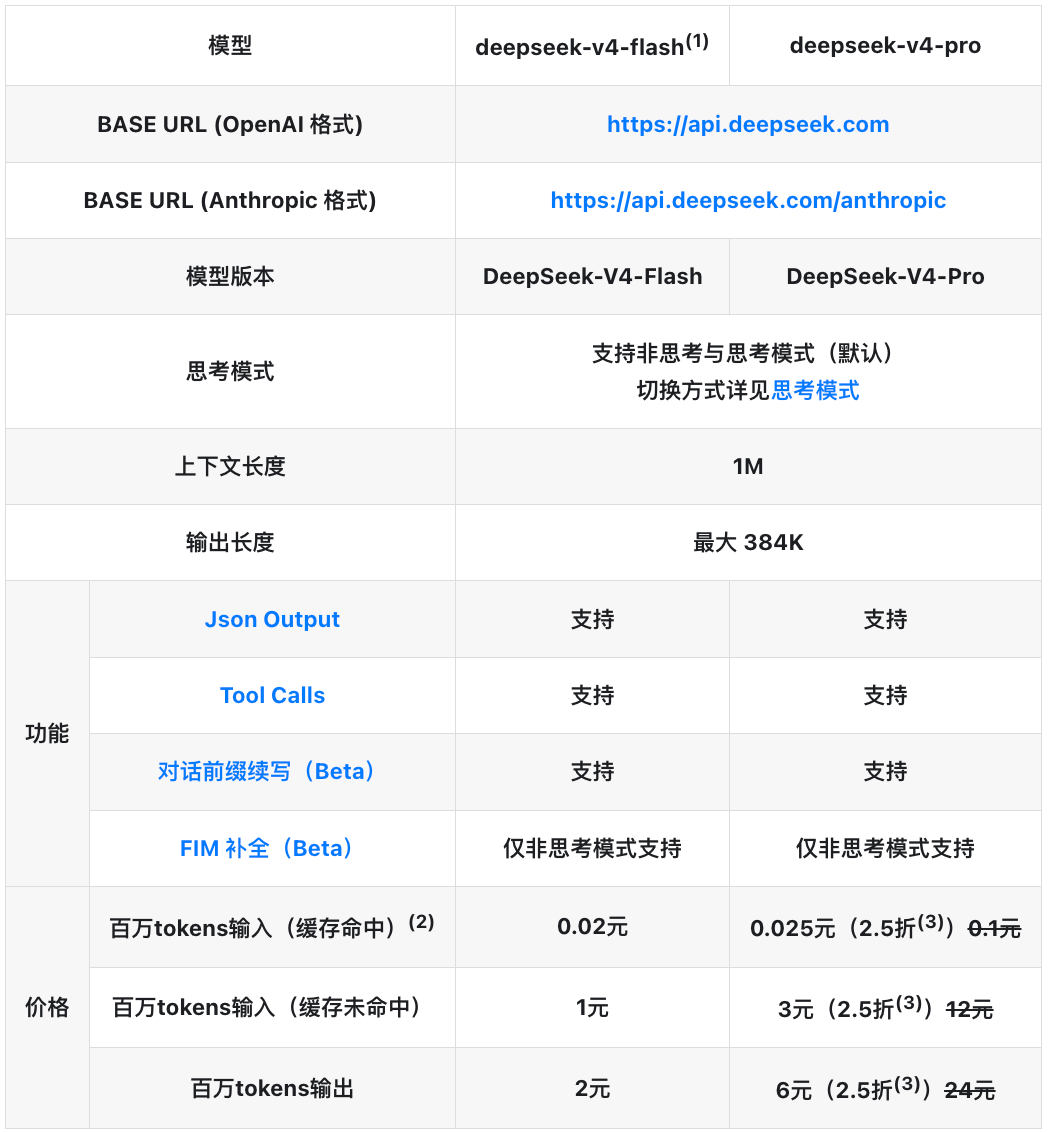
有/无命中缓存的输入,和输出的价格差 2-100 倍,这意味着让 AI 输出更简洁的内容通常更划算
在一个对话框中进行对话,会将当前对话的历史信息带上,这有利于对 AI 进行连续、有关联的提问,这些历史信息称之为上下文,一次对话(上下文)能处理的 Token 也是有限的,一但超过了上下文窗口的Token限制,最开始的提问就被遗忘。
上下文越长,消耗的Token也会越多,所以如果提问的问题没有关联性,及时新开窗口提问会比较节省Token
Prompt(提示词)
Prompt(提示词),是你输入给 AI 模型的指令、问题,高质量的提示词可以让 AI 产出最符合你需求的、高质量的内容,因此产生了很多专门分享 Prompt、共享 AI 提示经验的网站
优质的提示词有什么用?
- 提高准确性:减少 AI 跑题、答非所问的情况
- 节省时间:一次到位,减少结果的修改次数
- 解锁能力:负责推理、格式化输出、工具调用等能力,需要特定的技巧或描述才会触发
- 降低成本:好的提示词可以减少不必要的 Token 消耗,减少 AI 回答次数
不好的提示词: 帮我画一张小鸡破壳的图像
优化后的提示词: 稻草上正在裂开的鸡蛋的极端特写,超详细蛋壳纹理。新孵化的无羽小鸡,湿润皱褶的粉红色皮肤。14mm超广角镜头提供戏剧性透视,超写实8K风格,电影氛围。
Agent(智能体)
AI 智能体,是一个不仅能思考,还能执行任务、具备记忆能力的程序,比如 Cursor AI 编程就可以看作一个 AI Agent,不仅能通过对话框回答你的问题,还能直接帮你完成代码开发
其他诸如 AI 写 PPT、画图、制作视频等AI 工具也属于 Agent,2026 年爆火的 OpenClaw(小龙虾),属于一个系统级的 Agent,我们下达指令,OpenClaw可以直接访问操作系统、处理邮件、整理文件等等
AI Agent 的特征至少包含四点:
- 规划:对目标进行拆解、反思和改进
- 记忆:有短期记忆(上下文)和长期记忆(信息召回)的能力
- 工具:调用外部不同类型的工具/API,帮助任务的完成,比如搜索网页、执行脚本等
- 执行:结合上述特征能力,做出最终行动,得到结果
Workflow(工作流)
workflow(工作流),是按照预先定义的规则和顺序,执行的任务或步骤,主要是通过自动化解决重复任务的问题,比如:每天自动发送日报,可以拆解为:从指定的地方获取今日工作成果 -> 整理成邮件格式 -> 设置日报标题 -> 发送给特定的人
而 AI WorkFlow ,区别于普通 Workflow,则是在定义的规则框架内,运用 AI 进行有限的决策和流程处理,普通 WorkFlow 写死的分支流程,可以通过 AI 进行分析和流程判断
与 AI Agent 相比,两者主要体现在以下的不同
| Workflow(工作流) | Agent(智能体) | |
|---|---|---|
| 驱动方式 | 流程驱动 | 目标驱动 |
| 适用场景 | 固定流程 | 复杂动态任务 |
| 灵活性 | 低,路径固定 | 高,动态调整 |
| 人为干预 | 通常需要人为触发或监督 | 可独立运行,减少干预 |
Skills(技能)
Skill翻译过来是「技能」,Agent 可以智能地帮你完成任务,而 Skill 就是完成任务过程中的一个能力模块,比如压缩图片、发送邮件、总结文章内容等都可以视为一个 Skill
既然是一个模块,那意味着它是可复用的、可以规范化的,因此我们可以通过一个描述文件,为 Agent 写一个说明书,告诉 Agent 遇到需要用 Skill 时应该怎么处理,遵循什么规范,类似人类的 readme 文件
有无 Skill 时的对比:
| 问题 | 没有 Skills | 有 Skills |
|---|---|---|
| 重复描述 | 每次都要解释“如何做” | 一次定义,随时调用 |
| 知识遗忘 | 每次新的对话都从零开始,耗费 Token 较多 | 技能永久保存,有说明可以避免发散思考,减少 Token 损耗 |
| 质量不一 | 回答和执行每次都可能不同 | 标准化流程和输入 |
| 团队协作 | 每个人各自和 AI 沟通 | 团队共享统一的技能集 |